GDN mixed batch中消除重复QKV重排
这个PR是Qwen3.6 GDN路径上的内部性能优化,与前文的DFlash滑窗没有直接逻辑关系。它解决的问题可以概括为:
在一个同时包含decode token和prefill token的batch中,全部Q/K/V已经被重排过一次;旧代码又将最前面的decode token单独重排了一次。PR删掉第二次重排,直接复用第一次的结果。
前因:continuous batching会把prefill和decode放进同一个batch
产生mixed batch的根本原因是continuous batching。
同一个scheduling step里可能同时包含:
- 正在decode的请求,每个请求通常只有1个新token;
- 正在prefill的请求,本轮处理完整prompt或一段prompt chunk。
vLLM对这种batch有明确的排序约定:decode request在前,prefill request在后。split_decodes_and_prefills()利用这个顺序寻找两者的分界点。
当前这个batch不包含speculative sequence时,假设GDN metadata builder给出num_decode_tokens=D和num_prefill_tokens=P,mixed_qkv_non_spec布局是:
1 | mixed_qkv_non_spec |
只有同时存在这两类token时,split_non_spec才为True:
1 | split_non_spec = ( |
mixed batch为什么要再分成两条GDN路径
GDN在prefill和decode阶段使用不同算子:
- decode只需要用一个新token递推已有状态,使用
npu_recurrent_gated_delta_rule; - prefill需要处理长序列,使用
chunk_gated_delta_rule做分块并行。
两者在前面的输入投影和因果Conv1D阶段可以共用mixed tensor,但进入Gated Delta Rule时必须分流:
1 | hidden_states |
rearrange_mixed_qkv()的行为
输入mixed_qkv_non_spec是形如[N, q_dim + k_dim + v_dim]的打包tensor。decode和prefill的两个GDN kernel则需要的是分开且连续存储的Q、K、V,形状为[1, N, heads, head_dim]。
因此,需要在GatedDeltaNetAttention.rearrange_mixed_qkv()中重排QKV的内存结构:
1 | 重排前(按token打包): |
具体实现为先用torch.split拆出Q/K/V,然后用torch.cat将三者复制到一块新的连续buffer:
1 | query, key, value = torch.split( |
随后再将这块buffer分别view成Q、K、V:
1 | query = q_contig.view(1, seq_len, -1, self.head_k_dim) |
其中间的torch.cat会真正带来对内存的读取和写入。
旧代码的冗余操作
在所有non-spec token完成Conv1D后,旧代码先对整个mixed_qkv_non_spec执行了一次重排:
1 | query_non_spec, key_non_spec, value_non_spec = ( |
此时query_non_spec、key_non_spec和value_non_spec中已经同时包含decode token和prefill token,因此此时prefill token和decode token的QKV重排都已经完成。然而,在decode分支,代码又从最初的混合QKV中切片取出了取出decode token并再一次进行QKV:
1 | query_decode, key_decode, value_decode = self.rearrange_mixed_qkv( |
因此旧路径实际是:
1 | R([decode | prefill]) -> [Q decode | Q prefill, K decode | K prefill, V decode | V prefill] |
其中$R$表示rearrange_mixed_qkv()。第二次调用生成的值其实已经存在第一次调用的输出中。
修改前的profiling timeline也能直接看到这两段工作:第一段重排整个non-spec mixed batch,紧接着第二段又重排decode prefix。
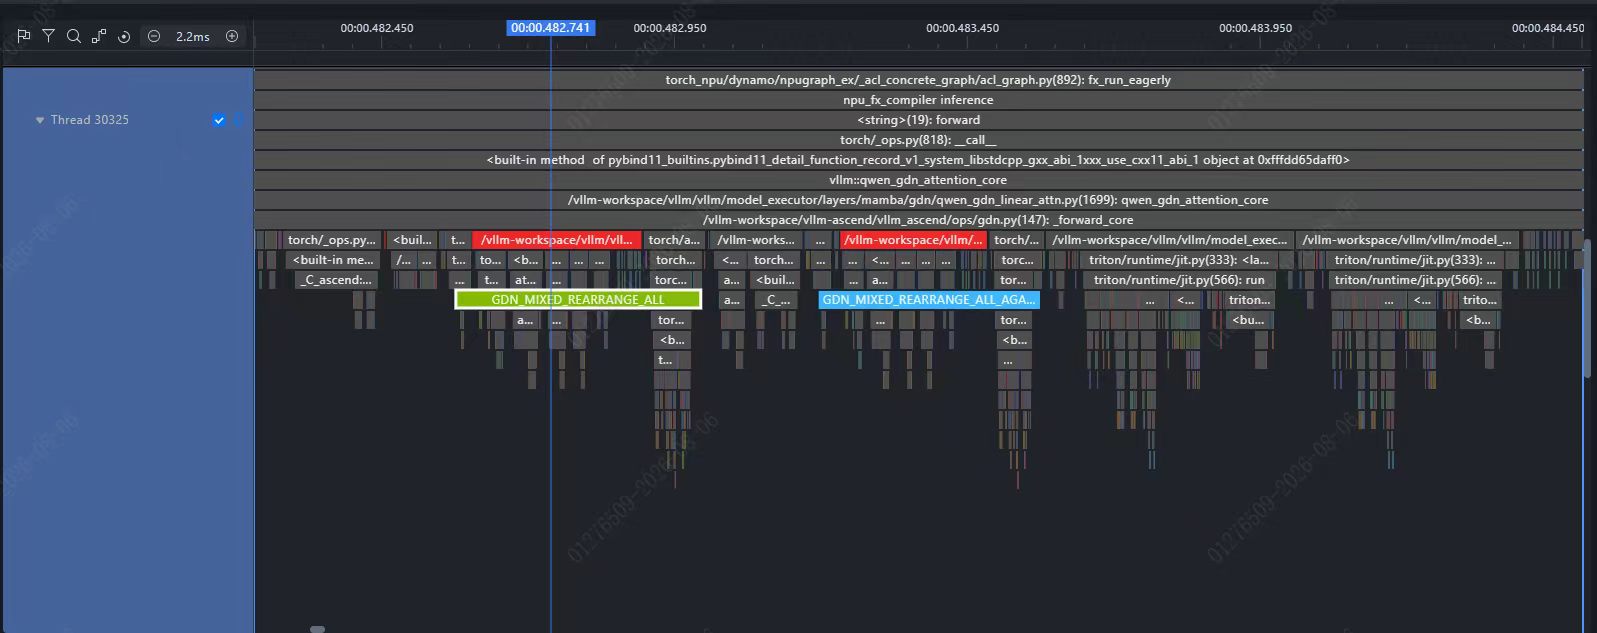
修改前:同一个GDN forward_core中出现两次QKV rearrange,第二次是对decode prefix的重复处理。
如何修改
不再对mixed_qkv_non_spec[:num_decode_tokens]做第二次重排,而是直接截取第一次重排结果的decode prefix:
1 | -query_decode, key_decode, value_decode = self.rearrange_mixed_qkv( |
这里的第0维是rearrange_mixed_qkv()添加的大小为1的维度,第1维才是token维,所以代码使用[:, :num_decode_tokens]。这些切片是已有Q/K/V buffer的view,不会再执行QKV拷贝。
整个路径现在变成:
1 | rearrange一次 |
修改后的timeline中,第二段decode-prefix rearrange不再出现;第一次full-batch rearrange产生的Q/K/V直接进入decode的L2Norm和recurrent GDN路径。
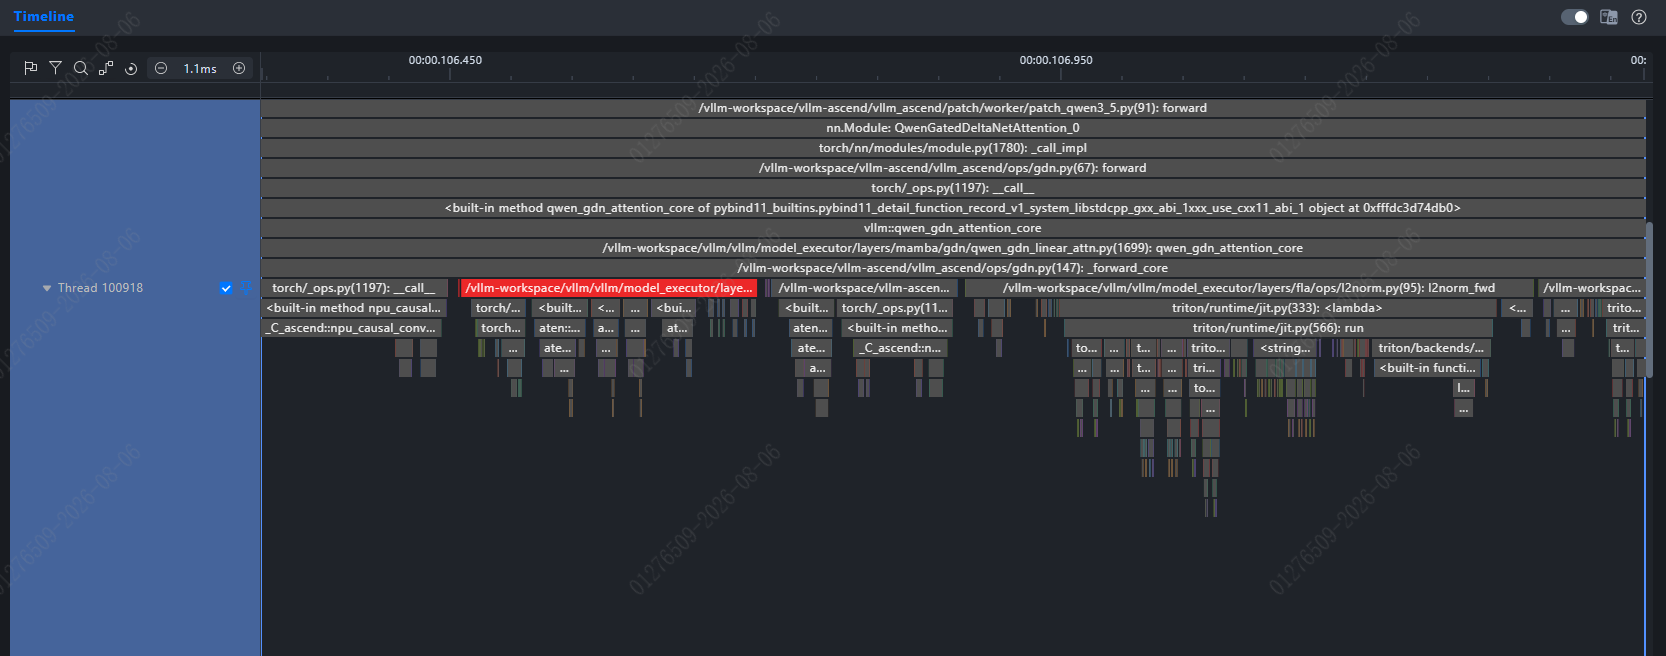
修改后:decode仅创建Q/K/V前缀view,不再启动第二个QKV copy kernel。
这个复用成立依赖三个前提:
- vLLM保证decode token是non-spec batch的连续前缀;
rearrange_mixed_qkv()只改变Q/K/V布局,不跨token计算;- decode分支只读取这些view。后面的
query_non_spec = query_non_spec[:, D:]只是让局部变量改为指向prefill后缀,不会改写decode view的底层数据。
因此,这个PR不会改变Q/K/V、GDN状态更新顺序或最终输出。
理论性能收益分析
这个修改每次命中mixed batch时,会在每个GDN层中减少:
- 1次
rearrange_mixed_qkv()调用; - 1次编译后的QKV copy kernel launch;
- $D×(q_{dim}+k_{dim}+v_{dim})$个元素的读取和写入,其中$D$是当前batch的decode token数。
Qwen3.6-27B有48个GDN层。以BF16、TP=2为例,每个rank上:
$$
q_{dim}+k_{dim}+v_{dim}=1024+1024+3072=5120,
$$
所以每个decode token每层需要被重排的数据是$5120\times2=10240$ byte,即10 KiB。如果decode concurrency为64,且每个decode request在本轮贡献1个token,旧路径每个GDN层的重复copy输出约为640 KiB;48个GDN层合计约30 MiB写入。若把读取原Q/K/V也算入HBM流量,则约为60 MiB/次model step/每个TP rank。
Ascend NPU正确性验证
在Qwen3.6-27B、2张Ascend 910B、TP=2、禁用投机解码、开启chunked prefill的环境中,构造了1个decode token + 4095个prefill token的mixed batch,在同一次model execution中对比旧路径和新路径。
结果是:
- Q/K/V完全一致;
- L2Norm后的Q/K完全一致;
- recurrent GDN输出和更新后的state中,NaN出现的位置一致,所有有限值逐bit一致。
这说明复用view没有引入数值误差,也没有改变GDN的输出状态。NaN mask一致的描述并不是说这个PR制造了NaN,而是验证时将原路径已有的NaN也纳入了严格对比。