Ascend 910B上DeepSeek-V4.1-Flash稀疏注意力算子的解析与优化
一、910B硬件架构
910B采用矩阵核与向量核分离的架构。图中的两个大框分别是矩阵核(AIC,AI Cube)和向量核(AIV,AI Vector)。两类核各有独立的标量单元(Scalar),可以各自执行指令,也可以分工完成同一个算子。本次分享涉及的910B单芯片配有20个AIC和40个AIV,通常按1个AIC搭配2个AIV协同执行。
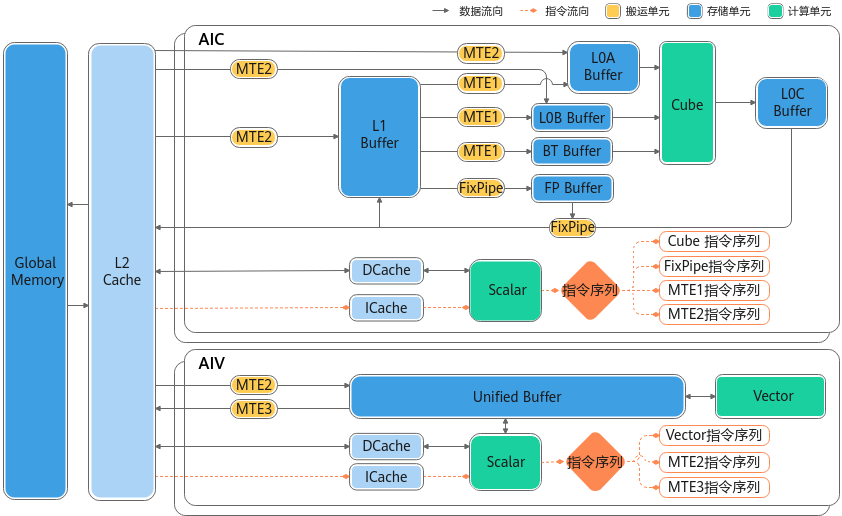
矩阵核AIC(图上半部)。 核内的Cube单元专门做矩阵乘加。以注意力为例,QKᵀ和PV的计算就由Cube单元负责。
向量核AIV(图下半部)。 核内的Vector单元从统一缓冲区(Unified Buffer,UB)取数,一条指令可以对多个元素执行相同的操作,也可以沿一行做归约。Softmax就用到了这两类运算。先求每行的最大值,再逐元素减去最大值、取指数,最后按行求和并归一化。稀疏KV的Gather也由AIV负责,具体由Scalar根据索引计算地址,搬运单元从相应位置取回KV。
一次Vector运算和一次Cube运算,数据怎么走?
| 运算 | 从全局内存(GM)读入,到结果写回GM |
|---|---|
| Vector | GM → MTE2 → UB → Vector → UB → MTE3 → GM |
| Cube | GM → MTE2 → L1 → MTE1 → L0A / L0B → Cube → L0C → FixPipe → GM |
L0A和L0B分别存放左、右矩阵,Cube从两者取数,在L0C中累加结果。Vector直接读写UB中的操作数。
从QKᵀ到Softmax,再到PV,要跨核交接两次。 AIC算出的分数走 L0C → GM → UB,交给AIV做Softmax。AIV算出的权重P再走 UB → GM → L1,交回AIC作为PV的左矩阵。
A2与A5、NVIDIA的对比
| 项目 | A2(910B) | A5(Ascend 950) | NVIDIA |
|---|---|---|---|
| 矩阵与向量计算之间的数据交换 | L1与UB之间经GM中转 | L1 ↔ UB双向直通,L0C → UB也可直达 | 同一线程块内可共用Shared Memory |
| SIMT编程 | 不支持,向量计算采用SIMD | 支持 | 支持,每个warp有32个线程 |
| 寄存器级计算(RegBase) | 向量指令读写UB(MemBase) | 支持,向量中间结果可保留在寄存器中 | 支持,中间结果可保留在线程寄存器中 |
二、DeepSeek-V4.1-Flash稀疏注意力算子的实现
Query 与 KV 的分块
以Prefill阶段的原生SparseFlashMla算子为例。在TP8下,一个query token在当前卡上有8个Q头(H8),每个头的维度为512,因此这条query的Q矩阵是 8 × 512。8个头共享同一组Top 512 KV。
一个Query的注意力计算会使用一组AIC + 2AIV组合,组合主循环每轮推进一种(一个)KV tile的注意力计算,滑窗KV tile和 TopK KV tile交替计算。从这组核接到第一条query开始编号。query 0的滑窗和TopK分别是tile 0和tile 1,query 1的滑窗和TopK分别是tile 2和tile 3。
| KV tile | 取数方式 | 每个块的QKᵀ形状 |
|---|---|---|
| 滑窗(128 × 512) | AIC按窗口范围和页表直接读取 | 8 × 128 |
| TopK(512 × 512) | 两个AIV按索引Gather,写成连续块供AIC读取 | 8 × 512 |
AIV三级流水线
第一级只Gather当前轮的TopK块。 滑窗块由AIC直接读取。遇到TopK块时,AIV0和AIV1合作将TopK KV块从 GM 中读入,然后写到临时的 GM Buffer 中供 AIC 计算 QK。其中,AIV0取 TopK 索引的前256行,AIV1取后256行。两核分别查页表,从KV Cache把对应行搬入各自的UB,每攒齐16行就写到GM工作区的对应位置,两核交齐后,512行KV才可用于QKᵀ。
第二级对上一轮进入流水线的tile做在线Softmax。 AIC交回一块QKᵀ分数后,AIV更新最大值和指数和,并把当前块的在线 Softmax 结果 P 写回 GM,供AIC做PV。H8时8个头都由AIV0处理。
第三级用两轮前进入流水线的tile更新输出。 AIC每算完一块PV,AIV0就得到对应 KV 对输出的贡献。对于滑窗块会先缓存滑窗结果。TopK块返回后,AIV0按更新后的最大值重缩放滑窗结果,加上TopK的贡献,再用累计的指数和归一化,写出最终结果。
AIC两级流水线
AIC交错执行QKᵀ和PV矩阵乘。
第一级计算当前tile的QKᵀ,把分数交给AIV。第二级等AIV算出上一个tile的权重P,再计算该tile的PV,把部分输出交回AIV。
第0轮只有AIC计算tile 0的滑窗QKᵀ。第1轮,tile 1进入流水线,AIV先Gather它的TopK KV,交给AIC算QKᵀ。随后AIV为tile 0做Softmax,AIC拿到P后算滑窗PV。
第2轮,query 1的滑窗开始算QKᵀ。此时query 0仍在流水线里:tile 1做Softmax和PV,tile 0的滑窗结果由AIV暂存。第3轮,五个阶段都有任务,AIV在更新输出阶段合并tile 0和tile 1的贡献,写回query 0。
一个流水线环节什么时候能开始?
一个阶段要开始执行,时序依赖、数据依赖和资源依赖必须同时满足。
| 依赖 | 定义 |
|---|---|
| 时序依赖 | 同一核按既定顺序下发各阶段,后续阶段要等本核推进到相应位置。 |
| 数据依赖 | 消费者读取某个输入前,生产者必须已写好这份数据,并通知消费者可以读取。 |
| 资源依赖 | 缓冲区复用时,生产者再次写入同一个缓冲槽前,上一位消费者必须已读完旧数据,允许该槽被覆盖。 |
以第7轮的Gather为例。三个TopK KV缓冲槽循环使用,tile 1和tile 7写入同一槽。沿虚线从右向左看,AIC读完tile 1的V之后,AIV才能用这个槽写tile 7。再沿实线从左向右看,两个AIV写齐tile 7的KV之后,AIC才能开始这个tile的QKᵀ。前一条依赖保护槽里的旧数据,后一条依赖交付本轮的新数据。
在910B上单卡复现TP8中rank 7的Prefill负载:4096条query,每条8个Q头,头维度512,32K上下文,滑窗128行、TopK 512行。
在5.29 µs,AIC进入tile 17的KV就绪等待。这个信号由AIV在KV Gather之后通过写回流水发出。12.79 µs等待返回,AIC才继续调用QKᵀ,两次打点相差7.50 µs。这说明,KV Gather的操作使AIC出现了大量的等待空泡,是整条流水线的瓶颈。
四、优化方案:让KV Gather和QKᵀ计算的流水线化
原流程要等512行TopK KV全部就绪,AIC才能下发QKᵀ。尝试将KV的拉取QKᵀ的计算流水线化以实现重叠,即两个AIV先取256行,向AIC发出就绪信号,接着取后256行。AIC收到第一份信号就能计算前半QKᵀ,收到第二份信号再计算后半QKᵀ。两半分数拼成完整的8 × 512矩阵,后续仍按整块做Softmax产生P,再做PV。
沿AIC这一行看,原流程在19.36 µs进入整块QKᵀ函数,分半后在12.03 µs就进入了前半QKᵀ函数。 此时AIV0已经在进行后半KV Gather,重叠掩盖了一半的QKᵀ计算时间。
实测显示,原版算子耗时4.035 ms,优化后为3.672 ms,单算子耗时下降8.99%。