论文原文:DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence
论文2.3声称,在长上下文的场景下,注意力计算已成为大语言模型推理主要的计算瓶颈。
DeepSeek采用了混合注意力机制,交错地在不同的Transformer层中使用HCA和CSA,且每层都包含了SWA的分支。
- CSA(Compressed Sparse Attention,压缩稀疏注意力)
- HCA(Heavily Compressed Attention,重度压缩注意力)
- SWA(Sliding Window Attention,滑动窗口注意力)
1 |
|
需要注意的是,CSA和HCA还使用了共享KV的多查询注意力(Shared Key-Value MQA):key和value使用同一个向量,并且所有query head共享唯一的KV head。
CSA:Compressed Sparse Attention
CSA的大致思路是,每$m$个相邻token生成一个KV entry,然后从这些KV entry中选择和当前query最相关的top-$k$个条目作为后续核心注意力使用的KV entry。给定隐藏层状态$H\in \mathbb{R}^{n\times d}$, CSA会输出共享KV矩阵$C^{CSA}\in \mathbb{R}^{n\times c}$。其中$n$为token长度,$d$为隐藏层维度。
压缩KV entry生成
给定隐藏层状态$H[n,d]$,CSA在这一步会为每$m$个token生成1个KV entry。
首先,每个token通过权重矩阵$W^{aKV}[d,c]$和$W^{bKV}[d,c]$生成两套原始KV entry。
$$
C^a = HW^{aKV};C^b=HW^{bKV}.
$$
然后通过权重矩阵$W^{aZ}[d,c]$和$W^{bZ}[d,c]$,分别计算两套KV entry中每个条目对应的压缩分数(分数越高,在压缩后条目的贡献越高)$Z^a[n,c]$和$Z^b[n,c]$。
$$
Z^a = HW^{aZ};Z^b=HW^{bZ}.
$$
然后,分别取每一个压缩组在$Z^a$中的$m$个分数和前一压缩组在$Z^b$中的$m$个分数,加上可学习的位置偏置$B^a \in \mathbb{R}^{m\times c}$和$B^b \in \mathbb{R}^{m\times c}$。两组分数拼接后,在行维度(即$2m$个token条目的维度)进行Softmax,得到对应KV条目在压缩时使用的权重。
$$
[S^a_{mi:m(i+1)-1};S^b_{m(i-1):mi-1}]
=\operatorname{Softmax}{\mathrm{row}}([Z^a{mi:m(i+1)-1}+B^a;Z^b_{m(i-1):mi-1}+B^b]).
$$
然后,使用$S^a$对每个压缩组的$m$个原始KV entry $C^a$逐元素加权,使用$S^b$对前一压缩组的$m$个原始KV entry $C^b$逐元素加权,并求和得到第$i$个压缩KV entry:
$$
C_i^{\mathrm{Comp}}
=\sum_{j=mi}^{m(i+1)-1}S_j^a\odot C_j^a
+\sum_{j=m(i-1)}^{mi-1}S_j^b\odot C_j^b.
$$
其中,$\odot$表示Hadamard积。对于第一个压缩组,来自前一组的$Z^b$用$-\infty$填充,$C^b$用$0$填充。由此,序列长度实际被压缩为原来的$1/m$,我们得到了压缩后的KV entry $C_i^{\mathrm{Comp}}\in\mathbb{R}^c$;所有压缩KV entry组成矩阵$C^{\mathrm{Comp}}\in\mathbb{R}^{\frac{n}{m}\times c}$。
top-k KV entry选择(Indexer)
在极长上下文的场景下,经过第一步压缩后,序列长度可能仍然很长,压缩后的KV entry中可能还是包含大量无关信息,因此,CSA使用一个Lightning Indexer,通过注意力打分,从压缩后的KV entry中选择和当前query最相关的k个KV entry供后续核心注意力计算使用。
Lightning Indexer实质上是一个小型的注意力模块,能够求取每个token对于某个压缩KV entry的相关度。
从隐藏状态$H\in\mathbb{R}^{n\times d}$出发,CSA会使用另一套权重参数和更小的维度,走一遍与计算$C_i^{\mathrm{Comp}}$相同的压缩流程,获得Lightning Indexer使用的key $K^{\mathrm{IComp}}=[K_0^{\mathrm{IComp}};K_1^{\mathrm{IComp}};\ldots;K_{\frac{n}{m}-1}^{\mathrm{IComp}}]\in\mathbb{R}^{\frac{n}{m}\times c^I}$,其中$c^I$是Indexer的头维度。其流程可以概括为:
$$
H\rightarrow K^{Ia},K^{Ib},Z^{Ia},Z^{Ib}\rightarrow K^{\mathrm{IComp}}.
$$
然后,对于某个token t的隐藏状态$h_t \in \mathbb{R}^d$,需要进行类似LoRA的低秩投影以生成多头的query。这个query是用来做indexer的,而不是核心注意力。
首先降维:
$$
c_t^Q=h_tW_{DQ}.
$$
其中,$W_{DQ}\in\mathbb{R}^{d\times d_c}$,$d_c$是query低秩投影的中间维度。
然后再升维:
$$
[q_{t,1}^{I};q_{t,2}^{I};\ldots;q_{t,n_h^I}^{I}]
=q_t^I=c_t^QW^{IUQ}.
$$
其中,$W^{IUQ}\in\mathbb{R}^{d_c\times(c^I n_h^I)}$是Indexer query的升维矩阵;$n_h^I$是Indexer query head的数量;$c^I$是每个Indexer query head的维度。因此$q_t^I\in\mathbb{R}^{c^I n_h^I}$,拆分后token $t$的第$h$个Indexer query head $q_{t,h}^I\in\mathbb{R}^{c^I}$,可以与第$s$个压缩KV entry对应的Indexer key $K_s^{\mathrm{IComp}}\in\mathbb{R}^{c^I}$计算内积。由此,每个token的每个Indexer query head都会对历史压缩块进行打分。在因果语言建模中,query token $t$只考虑位于其当前压缩块之前的key,即$s<\lfloor t/m\rfloor$。token $t$的第$h$个Indexer query head对第$s$个历史压缩块计算的分数为:
$$
r_{t,s,h}=\operatorname{ReLU}\left(q_{t,h}^I\cdot K_s^{\mathrm{IComp}}\right).
$$
Indexer会汇总不同Indexer query head对同一个压缩KV entry的分数。首先由隐藏状态投影出每个token对应的head权重:
$$
[w_{t,1}^I;w_{t,2}^I;\ldots;w_{t,n_h^I}^I]
=w_t^I=h_tW^w,
\qquad W^w\in\mathbb{R}^{d\times n_h^I}.
$$
然后对各head的分数进行加权求和,得到query token $t$与历史压缩块$s$之间的最终索引分数$I_{t,s}\in\mathbb{R}$:
$$
I_{t,s}=\sum_{h=1}^{n_h^I}w_{t,h}^I,r_{t,s,h}
=\sum_{h=1}^{n_h^I}w_{t,h}^I\operatorname{ReLU}\left(q_{t,h}^I\cdot K_s^{\mathrm{IComp}}\right).
$$
汇总完毕后,从$I_{t,:}$中选出分数最高的$k$个历史压缩块,并取出这些位置在$C^{\mathrm{Comp}}$中对应的KV entry,组成供核心注意力使用的稀疏KV集合:
$$
C_t^{\mathrm{SprsComp}}
=\left{C_s^{\mathrm{Comp}}\mid I_{t,s}\in\operatorname{TopK}(I_{t,:},k)\right}.
$$
即送入后续核心注意力的是与top-$k$索引对应的$C^{\mathrm{Comp}}$。
整个流程如下图所示。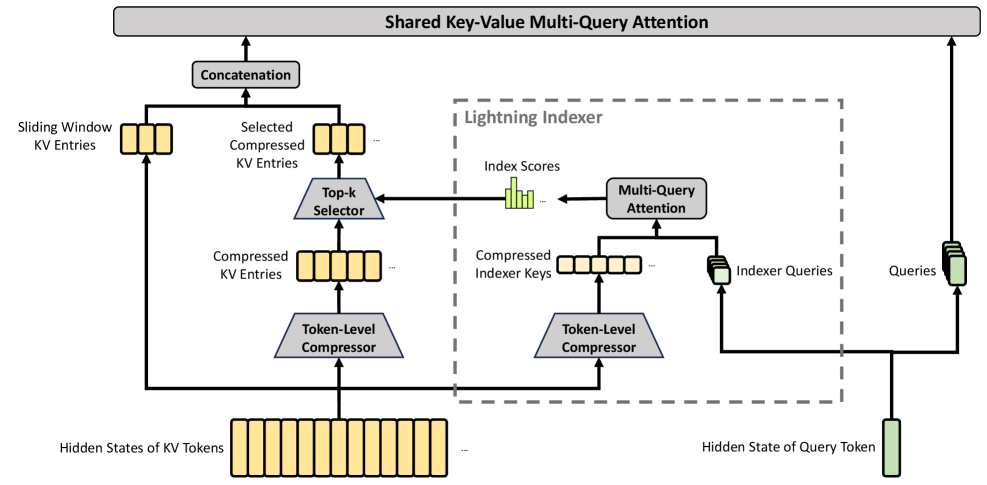
共享KV的多查询注意力
传统的GQA(Grouped-Query Attention,分组查询注意力)包含多个KV head:$n_h$个query head被划分成若干组,每组共享一个KV head,但同一个KV head中的key和value仍由两套不同的向量表示。MQA(Multi-Query Attention,多查询注意力)更进一步,让所有query head共享唯一的KV head。
CSA在MQA的基础上继续共享key和value:每个压缩KV entry既作为key,也作为value。
通常,在得到query、key和value向量后,先计算query与key的点积并进行Softmax归一化,再使用归一化后的注意力权重对value加权求和;这一过程称为注意力机制中的核心注意力计算。
在CSA的核心注意力计算中,query复用Indexer中得到的隐层状态的低维投影$c_t^Q$,通过另一套升维矩阵$W^{UQ}$生成$n_h$个query head:
$$
[q_{t,1};q_{t,2};\ldots;q_{t,n_h}]
=q_t=c_t^QW^{UQ},
\qquad W^{UQ}\in\mathbb{R}^{d_c\times(cn_h)}.
$$
其中,每个$q_{t,h}\in\mathbb{R}^c$。第$h$个query head的核心注意力输出为:
$$
o_{t,h}=\operatorname{CoreAttn}
\left(q_{t,h},,C_t^{\mathrm{SprsComp}},,C_t^{\mathrm{SprsComp}}\right).
$$
公式中后两个参数分别表示key和value,二者使用同一组$C_t^{\mathrm{SprsComp}}$;同时,这一组压缩KV entry由所有query head共享。因此,CSA只需缓存一个共享KV head。
分组输出投影
设query token $t$的核心注意力需要访问$\ell_t$个KV entry,将它们按行排列为$\mathcal{C}t\in\mathbb{R}^{\ell_t\times c}$。$n_h$个query head产生的Softmax权重组成$A_t\in\mathbb{R}^{n_h\times\ell_t}$,加权求和后得到各注意力头的输出:
$$
O_t=A_t\mathcal{C}t
=[o{t,1};o{t,2};\ldots;o_{t,n_h}]
\in\mathbb{R}^{n_h\times c}.
$$
传统做法会将$O_t$展平为长度为$cn_h$的向量,再通过$W^O\in\mathbb{R}^{cn_h\times d}$直接投影回隐藏层维度$d$。DeepSeek-V4中$cn_h$较大,直接投影的计算开销较高,因此采用分组输出投影:先将$n_h$个注意力头平均分成$g$组,再将每组独立投影到较小的中间维度$d_g$,最后拼接各组的中间结果并投影到$d$维。
HCA: Heavily Compressed Attention
由于CSA仅选择top-k相关的KV entry进行注意力计算,仅使用CSA可能会丢失一些背景信息,由此DeepSeek还引入了HCA机制,即将所有KV entry每$m’$个压缩成一个KV条目进行注意力计算。
具体来说,从隐藏层状态$H\in\mathbb{R}^{n\times d}$出发,通过权重矩阵$W^{KV}\in\mathbb{R}^{d\times c}$投影得到原始KV矩阵$C\in\mathbb{R}^{n\times c}$,通过权重矩阵$W^Z\in\mathbb{R}^{d\times c}$投影得到压缩权重矩阵$Z\in\mathbb{R}^{n\times c}$。
对于压缩权重$Z$,每$m’$个token会在增加偏置项$B\in\mathbb{R}^{m’\times c}$后做softmax,然后基于softmax分数求出压缩KV Entry:
$$
\begin{aligned}
C&=HW^{KV},\
Z&=HW^Z,\
S_{m’i:m’(i+1)-1}
&=\operatorname{Softmax}{\mathrm{row}}\left(Z{m’i:m’(i+1)-1}+B\right),\
C_i^{\mathrm{Comp}}
&=\sum_{j=m’i}^{m’(i+1)-1}S_j\odot C_j.
\end{aligned}
$$
流程如下图: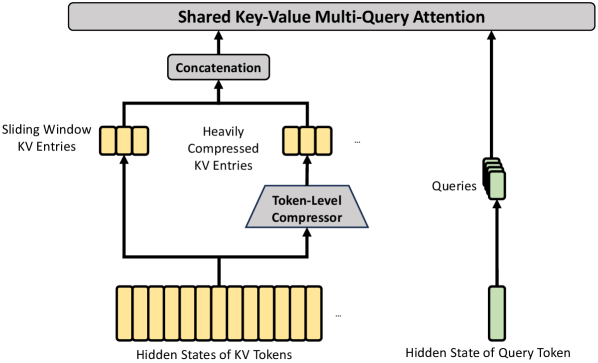
SWA: Sliding Window Attention
CSA和HCA都只允许query关注当前压缩块之前的完整压缩块,以保证因果性。当前块的压缩KV entry会聚合块内所有token,其中可能包含query之后的未来信息,因此不能直接参与当前query的注意力计算。这样一来,query便无法通过压缩分支访问同一块中位于自己之前的token;同时,压缩操作本身也会损失一部分细粒度的局部信息。
为此,DeepSeek-V4在CSA层和HCA层中都增加了SWA分支。设滑动窗口大小为$n_{\mathrm{win}}$,对于query token $t$,SWA保留最近$n_{\mathrm{win}}$个token对应的未压缩KV entry:
$$
C_t^{\mathrm{SWA}}
=\left[C_j^{\mathrm{SWA}}\mid
\max(0,t-n_{\mathrm{win}}+1)\le j\le t\right].
$$
这些KV entry不经过CSA或HCA的压缩过程,因此能够保留近期上下文中更精细的token级信息。
在CSA层中,SWA分支的未压缩KV entry会与Indexer选出的top-$k$个CSA压缩KV entry合并:
$$
\mathcal{C}_t^{\mathrm{CSA}}
=\left[C_t^{\mathrm{SWA}};C_t^{\mathrm{SprsComp}}\right].
$$
在HCA层中,SWA分支则与所有位于当前块之前的HCA压缩KV entry合并。令$C_i^{\mathrm{HCAComp}}$表示第$i$个HCA压缩块,则:
$$
\mathcal{C}t^{\mathrm{HCA}}
=\left[C_t^{\mathrm{SWA}};
C_0^{\mathrm{HCAComp}};\ldots;
C{\lfloor t/m’\rfloor-1}^{\mathrm{HCAComp}}\right].
$$
合并后的$\mathcal{C}t$同时作为共享的key和value,与低秩投影生成的query进行核心注意力计算:
$$
o{t,h}=\operatorname{CoreAttn}
\left(q_{t,h},\mathcal{C}_t,\mathcal{C}_t\right).
$$
MoE
传统Transformer的FFN中,所有token共享同一个前馈网络。以DeepSeek使用的SwiGLU为例,FFN包含门投影、上投影和下投影:
$$
a_t^{\mathrm{gate}}=W^{\mathrm{gate}}x_t,\qquad
a_t^{\mathrm{up}}=W^{\mathrm{up}}x_t,
$$
$$
y_t=W^{\mathrm{down}}\left(\operatorname{SiLU}(a_t^{\mathrm{gate}})\odot a_t^{\mathrm{up}}\right).
$$
MoE让多个“专家”分别持有一套门投影、上投影和下投影参数,可独立完成一次FFN计算:
$$
E_i(x_t)=W_i^{\mathrm{down}}\left(
\operatorname{SiLU}\left(W_i^{\mathrm{gate}}x_t\right)
\odot W_i^{\mathrm{up}}x_t
\right).
$$
每个token只激活被路由选中的top-$k$个专家,并对这些专家的输出加权求和,即:
$$
y_t=\sum_{i\in\mathcal{T}t}g{t,i}E_i(x_t).
$$
DeepSeek MoE引入了Shared Expert机制,即无论路由结果如何,Shared Expert都会处理每个token,
输出变成:
$$
y_t=E_{\mathrm{Shared}}(x_t)+\sum_{i\in\mathcal{T}t}g{t,i}E_i(x_t),
$$
其中$E_{\mathrm{Shared}}$同样由一套独立的门投影、上投影和下投影构成,但它不受路由选择影响,始终参与计算。
在专家路由方面,DeepSeek V4采用的路由函数为$\operatorname{Sqrt}(\operatorname{Softplus}(\cdot))$,用它计算token在各专家上的分数。
此外,在早期层,DeepSeek采取了基于token id的简单路由,即根据输入token id和预定义的hash函数直接确定目标专家;门控分数仍用于对这些专家的输出进行加权。
1 | DEEPSEEK_V4_MLP_LAYER_TYPES = ("hash_moe", "moe") |
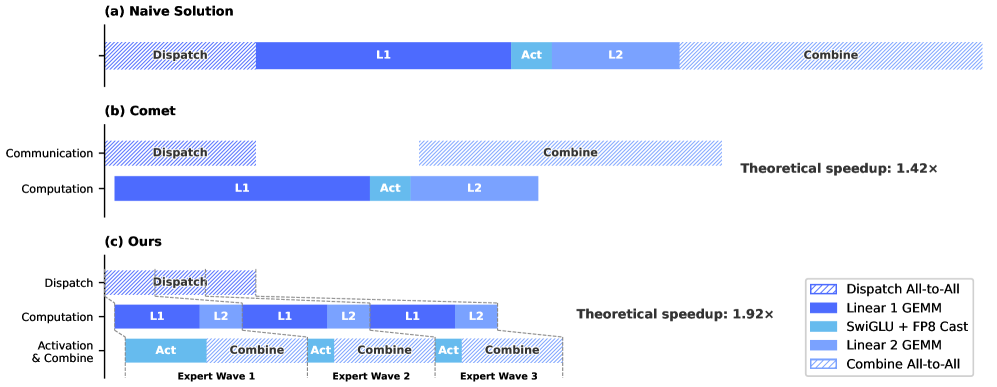
在实现上,DeepSeek MoE采用了基于wave的细粒度通信-计算重叠技巧。
一次FFN计算包含分发(将token发送到对应专家)、L1(上投影和门投影)、L2(下投影)、组合(聚合各专家的前向传播结果)四个阶段。
在串行的EP实现中,分发、L1、L2、组合串行执行,在分发、组合时,GPU计算单元空闲。
因此,可以将操作流水线化,某个rank专家不必等到本rank负责的所有token都收到了才开始计算,而是可以收到一批、计算一批。
DeepSeek V4进一步地将专家分成多个wave,一些wave在通信时,另一些wave可以计算,进一步地重叠了通信与计算。