vLLM 启动后被 Killed 的排错记录
1. 问题现象
启动 vLLM 推理服务后,进程没有打印 Python 异常栈,只在终端中显示:
1 | Killed |
随后检查退出码:
1 | echo $? |
结果为:
1 | 137 |
2. 退出码 137 的含义
Linux 进程退出码通常可以表示为:
1 | 128 + 信号编号 |
因此:
1 | 137 = 128 + 9 |
信号 9 是:
1 | SIGKILL |
这说明进程被操作系统或外部管理组件强制终止。SIGKILL 无法被进程捕获,所以 Python 来不及打印 traceback。
常见原因包括:
- 容器内存超过限制,被 OOM Killer 杀掉;
- Kubernetes 或作业调度器主动终止进程;
- 管理员手动执行
kill -9; - 极少数情况下,设备或驱动异常导致外部组件终止进程。
3. 使用 PyTorch 做最小测试
为了判断问题是否只发生在 vLLM,执行最简单的设备检测:
1 | python -u - <<'PY' |
测试结果仍然是:
1 | Killed |
这说明问题发生在 PyTorch/设备后端初始化阶段,不只与 vLLM 上层逻辑有关。
沐曦适配版 PyTorch 可能沿用
torch.cuda接口名称,但底层实际使用的是 MXMACA 软件栈。
4. 排查 GPU 是否损坏
一度怀疑沐曦 C500-S 本身存在硬件故障,因此编译并运行 MXMACA SDK 自带的 vectorAdd 示例。
vectorAdd 会实际执行以下流程:
1 | 申请设备内存 |
示例编译、执行和结果校验均正常。
因此可以判断:
- GPU 能被驱动识别;
- MXMACA Runtime 正常;
- 设备内存申请正常;
- Host/Device 数据拷贝正常;
- GPU Kernel 能正常启动和执行;
- 硬件损坏的可能性很低。
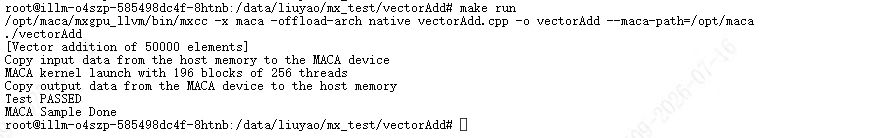
问题范围缩小到容器资源限制或 PyTorch/vLLM 初始化过程。
5. 怀疑发生 OOM
Killed 加退出码 137 很符合 OOM Kill 的表现,因此尝试查看内核日志:
1 | dmesg -T | grep -Ei 'out of memory|oom|killed process' |
以及:
1 | journalctl -k --since "10 minutes ago" |
容器内没有权限读取宿主机内核日志,journalctl 输出:
1 | No journal files were found |
这在 Kubernetes 容器中很常见:Pod 通常无法直接读取宿主机的内核日志。
6. 什么是 cgroup
cgroup 全称是 Control Group,是 Linux 内核用于限制、统计和隔离进程资源的一套机制。
它可以控制或统计CPU 使用量、主机内存使用量、Swap、进程数量、块设备 I/O、其他系统资源等。
Kubernetes 的 Pod/Container 内存限制最终通常由 cgroup 实现。
例如 Pod 配置了:
1 | resources: |
Linux 会为该容器设置一个 cgroup 内存上限。容器内所有进程的总内存达到上限后,内核可能在该 cgroup 内选择进程执行 OOM Kill。
本环境使用的是 cgroup v1,相关文件位于:
1 | /sys/fs/cgroup/memory/ |
常用字段:
1 | memory.limit_in_bytes 容器内存上限 |
查询命令:
1 | CG=/sys/fs/cgroup/memory |
7. 发现明确的 OOM 证据
最初容器内存上限为:
1 | 17179869184 bytes = 16 GiB |
历史峰值为:
1 | 17179201536 bytes ≈ 16 GiB |
memory.oom_control 显示:
1 | oom_kill_disable 0 |
含义:
oom_kill_disable 0:允许内核执行 OOM Kill;under_oom 0:当前没有处于 OOM 状态;oom_kill 1:该 cgroup 生命周期内累计发生过 1 次 OOM Kill。
随后进行对照测试:
- 执行一次
torch.cuda.is_available(); - 进程再次显示
Killed; oom_kill计数增加 1。
这说明 PyTorch 初始化设备后端时触发了容器 OOM。
之后直接启动一次 vLLM:
- vLLM 启动过程中被
Killed; oom_kill计数一次增加了 4。
这通常表示 vLLM 启动了多个 worker/子进程,多个进程在初始化过程中先后被 OOM Killer 终止。
因此最终可以确认:
1 | vLLM 启动失败的直接原因是容器主机内存不足, |
8. 解决办法
将容器内存限制从 16 GiB 提升到 56 GiB。
扩容后:
torch.cuda.is_available()可以正常完成;- vLLM 推理服务可以正常启动;
- 不再出现
Killed; oom_kill计数不再继续增长。
9. 最终结论
完整排错链路如下:
1 | vLLM 启动后直接 Killed |
10. 可复用的快速诊断命令
遇到程序只显示 Killed 时,可以先执行:
1 | echo $? |
若结果为 137,继续检查 cgroup v1:
1 | CG=/sys/fs/cgroup/memory |
如果满足:
1 | memory.max_usage_in_bytes 接近 memory.limit_in_bytes |
就可以确认发生了容器级 OOM Kill。